Letztes Jahr bei heise (genauer gesagt im iX Magazin im November 2025): Ein Artikel, der sich dem gefühlten ewigen Glaubenskrieg widmet: Der Einsatz von Cloud-Hyperscaler gegen On-Premises. Die Kernbotschaft des Autors, hübsch verziert mit einem schicken Philosophie-Drop („Nirvana Fallacy“):
Hört auf zu jammern, wenn AWS, GC oder Azure mal husten. Selbst gehostet knallt es doch viel öfter, also alles ab in die Cloud was nicht bei drei auf den Bäumen ist. Und wenn ihr eh gerade schon dabei seid, am besten alle eure Daten gleich mit!
Klingt auf dem Papier erst mal logisch. Wenn man aber mal kurz Bleistift, Zettel und den Taschenrechner rausholt und die Realität aus dem Admin-Alltag in Zahlen danebenlegt, merkt man schnell: Hier werden nicht nur Äpfel mit Birnen verglichen, sondern ein einzelner fauler Apfel mit einer komplett abgebrannten Obstplantage.
Falls ihr euch jetzt fragt: Warum haben wir ausgerechnet am Freitag, den 13. einen Artikel der sich mit einem Artikel vom letzten Jahr befasst?
Aus aktuellem Anlass machen wir das Fass heute nochmal neu auf und gucken uns nicht nur den alten Artikel sondern auch die Diskussion darum an. Außerdem beobachten wir den Stand der Dinge mit Argusaugen. Vor allem werfen wir auch mal einen Blick auf die Milchmädchenrechnung hinter den „großen, kurzen, gar nicht soo schlimmen“ Cloud-Ausfallstatistiken. Habt ihr gar nicht mitbekommen? Okay, ich hole euch erstmal ab:
Zusammenfassend kann man sagen
…die Kacke dampfet gar sehr!
Wer den Schaden hat, braucht natürlich sich keine Sorgen darum machen, dass auch der eine oder andere spottet – oder so ähnlich geht das Sprichwort.
Ein Highlight möchte ich euch an der Stelle nicht vorenthalten. Besonders angetan haben es mir die angehenden Marketing Spezialisten, die direkt einmal eine Umfirmierung für Produkte vorgeschlagen haben. Microsoft könnte sein Office Abo ja jetzt in Microsoft 364 umbenennen. Peak.
Der im Artikel so genannte „BlastRadius-KPI“ oder: Wie man sich die Welt schönrechnet
Um die Ausfälle von AWS, Azure und Google Cloud irgendwie messbar zu machen, hat der Autor kurzerhand eine klasse universelle Metrik am Start: den BlastRadius-KPI. Man nehme die Stunden des Ausfalls und multipliziere sie mit einem geschätzten Schweregrad von 1 bis 5.
Das Ergebnis: AWS kommt seit 2020 auf schlappe 45,5 Ausfallstunden, Azure auf 22. Klingt traumhaft, oder? Im eigenen Serverraum raucht ja gefühlt schon öfter mal der Netzwerkstack ab, wenn die Putzkolonne den falschen Stecker zieht und der Core-Switch oder Main Server down geht.
Das Problem an der Sache: Diese Rechnung betrachtet den Ausfall ausschließlich aus der gemütlichen Perspektive des Anbieters, oder anders gesagt als wäre ein globaler Cloud-Dienst eine isolierte Insellösung.
Wenn bei mir im Keller der lokale Mailserver für 4 Stunden die Grätsche macht, dann stehen 4 Stunden lang die Mails still. Blöd, aber überschaubar. Dann gehen halt paar eMails paar Stunden später auf die wilde Fahrt. Wenn aber bei Microsoft 365 oder Azure (wie beim Entra-ID- oder Front-Door-Ausfall) für 8 oder 24 Stunden das Licht ausgeht, dann reden wir nicht über einen Betroffenen. Wir reden über das digitale Rückgrat von vielen Millionen Unternehmen gleichzeitig.
Die 24-Millionen-Stunden-Rechnung
Machen wir mal das Gedankenspiel, das damals schon in den heise-Kommentaren völlig zu Recht aufgemacht wurde: Nehmen wir an, eine zentrale Cloud-Plattform wie Microsoft 365 hat einen massiven Ausfall von 24 Stunden. Im Hochglanz-Report des Anbieters steht dann: „Wir hatten 24 Stunden Downtime. Passiert, 99,9 % SLA-Ziel trotzdem fast erreicht, weitermachen!“
Auf der anderen Seite der Leitung sitzen aber exemplarisch 1 Million betroffene Unternehmen (und bei M365 sind es weltweit noch deutlich mehr), die ihre komplette IT-Infrastruktur, in diesem Fall von Outlook über Teams, SharePoint und OneDrive bis hin zur ihrer gesamten Firmen-Benutzerauthentifizierung (Entra ID / AD) natürlich genau auf diese eine Karte gesetzt haben.
Aus 24 Stunden Ausfall beim Anbieter werden in diesem Beispiel auf einen Schlag 24.000.000 Stunden Unternehmens-Stillstand.
Und das ist ja erst der Anfang. Wenn mein lokaler eMail-Server spinnt, koche ich mir einen Kaffee, ziehe das letzte Backup zurück oder starte evtl. sogar nur den Dienst neu. Wenn die Cloud weg ist, mache ich genau gar nichts, außer blöd gucken. Ich sitze vor dem Bildschirm, starre auf das Status-Dashboard (das ironischerweise oft selbst in der betroffenen Cloud liegt und deshalb auch nur einen lustig rotierenden Ladebalken zeigt) und warte darauf, dass irgendwo in Redmond (und/oder Frankfurt, Dublin, Amsterdam etc.) jemand das richtige Kabel wieder einsteckt.
Der wahre Spaß beginnt allerdings erst dann, wenn die Cloud wieder da ist
Was in solchen „Cloud ist ja so viel stabiler“-Vergleichen komplett unter den Tisch fällt, ist der Rattenschwanz danach. Ein Ausfall von einem Tag bedeutet in der Realität selten nur einen Tag Verlust von Arbeitszeit.
- Der kreative Workaround-Wildwuchs: Wenn Teams, SharePoint und Mails tot sind, hören Menschen nicht einfach auf zu arbeiten, statt dessen werden sie kreativ. Plötzlich werden hochsensible Excel-Listen über private WhatsApp-Gruppen geschickt, Angebote landen auf lokalen Desktops, und wichtige Absprachen laufen über irgendwelche Schatten-IT-Tools, die irgendwer vllt. am Rand sogar noch auf dem Schirm hatte. Oder auch nicht. Was dann am Ende wo landet? Who knows.
- Die große Nacharbeit: Ist die Cloud am nächsten Tag idealerweise wieder online, beginnt der eigentliche Spaß. Alle lokal gespeicherten Dateien müssen wieder ins SharePoint eingepflegt werden. Versionierungskonflikte, Duplikate, Fehleingaben bei Übertragung von A nach b ohne Ende. Noch das kleinste Übel in der Situation: E-Mails, die im Nirwana hingen, trudeln unsortiert ein. Aufträge müssen händisch nachgetragen werden.
- Die Fehlerquote: Unter Zeitdruck wird der Kram vom Vortag schnell irgendwie ins System gekloppt. Zahlendreher, überschriebene Dokumente, vergessene Freigaben. Wer so was schon mal mitgemacht hat, weiß: das zieht sich über Wochen durch die Prozesse. Manches fällt einem im schlimmsten Fall dann sogar erst bei der nächsten Prüfung durch den Steuerberater auf – oder noch schlimmer – bei der nächsten Steuerprüfung. Meh!
Ali nix schuld?
Insider Infos hab ich zwar keine, aber es gibt hier so ein paar übliche Verdächtige, wenn mal wieder was schief geht dass gern dann gleich weltweite Auswirkungen hat.
Spontan würde ich erstmal Hermine tippen, Ron und Harry sind aber auch recht hoch im Kurs. Warten wir mal ab was nach dem Wochenende bei raus gekommen ist:
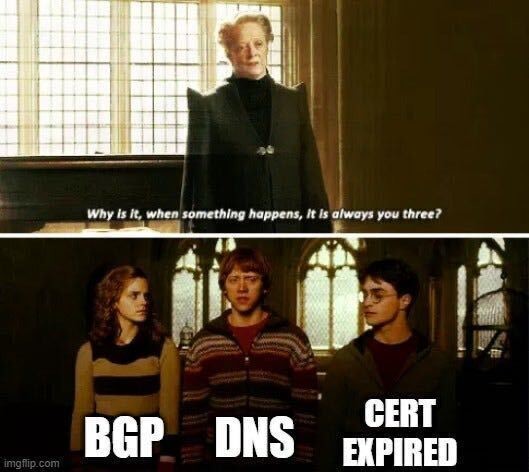
Wobei, einen hab ich noch. Kennt ihr das DNS Haiku? Nicht?
Kein Problem, i got you covered:
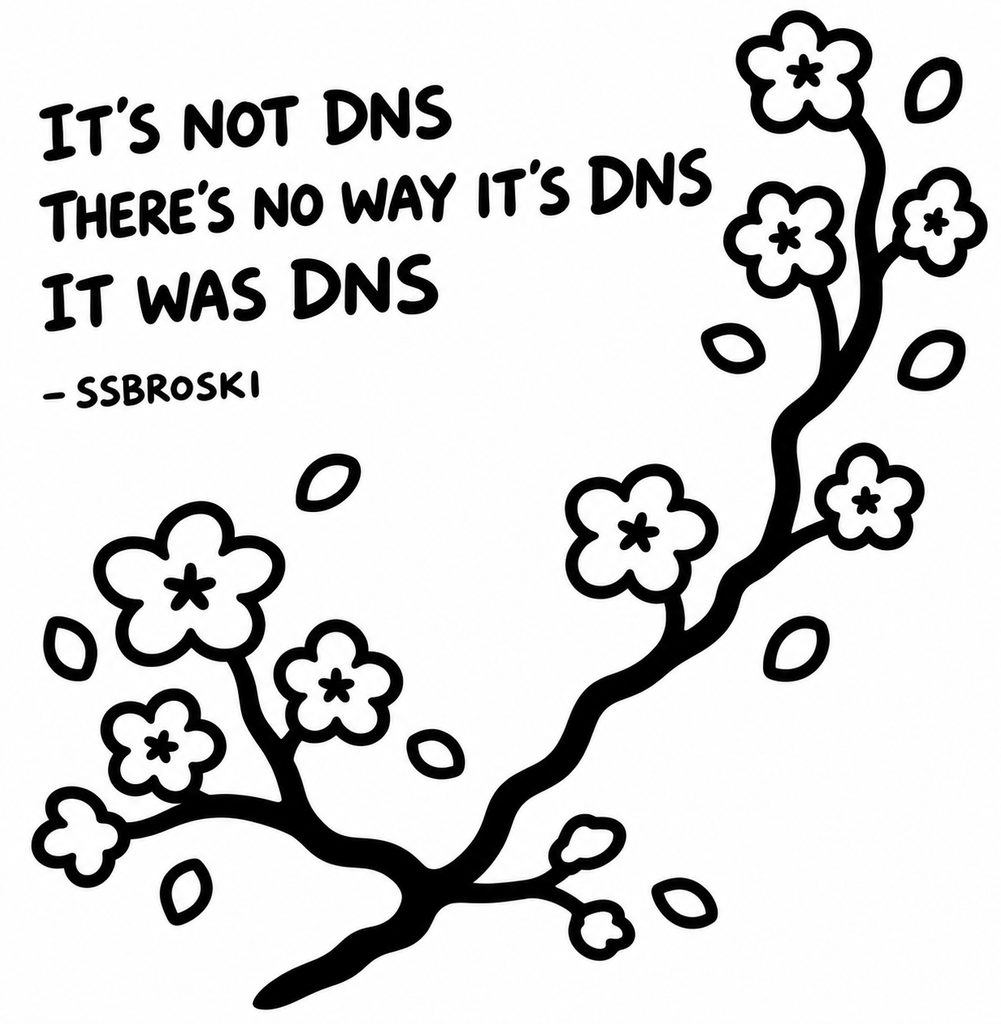
Oder darf es ein Limerick sein? Kein Problem. Kommt übrigens aus der gleichen Reddit Quelle 😉
there once was a service domain
that handed out Internet names
but when packets are lost
the records get tossed
and a „slow computer“ gets blamed
Unfaire Vergleiche: Umfragen gegen Hochglanz-Statusseiten
Auch bei der Datengrundlage im Artikel knirscht es gewaltig. Um zu beweisen, wie schlecht On-Premises läuft, wird eine freiwillige Mitarbeiter-Umfrage herangezogen, bei der sich ein Drittel über wöchentliche „IT-Störungen“ beklagt.
Mal ehrlich: Für den durchschnittlichen Büro-Anwender ist es schon eine „massive IT-Störung“, wenn die Batterie der Maus leer ist, der Drucker im dritten Stock kein Papier mehr hat oder das WLAN im Konferenzraum kurz hakt. Das dann mit einem globalen DNS- oder Authentifizierungs-Crash eines Hyperscalers gleichzusetzen, bei dem weltweit Flughäfen, Krankenhäuser und Zahlungsdienstleister stillstehen, ist schon sportlich.
Gleichzeitig wird bei On-Premises die Ransomware-Keule geschwungen (24 Tage Wiederherstellung im Schnitt). Ja, Ransomware ist die Pest. Aber so zu tun, als wäre die Cloud davor gefeit, ist naiv. Wenn der Admin-Account in der Cloud per Token-Diebstahl gekapert wird (der Artikel gibt selbst zu, dass die Control Planes nun mal immer offen im Netz hängen), dann löscht oder verschlüsselt dir der Angreifer wenn er Bock drauf hat deinen Tenant genauso effizient, nur eben aus der Ferne. Yay!
Fazit für die Praxis: Keine Panik, aber Hirn einschalten
Versteht mich nicht falsch: Ich bin kein Cloud-Hater. Hyperscaler patchen schneller als jedes mittelständische IT-Team, und niemand von uns will sich freiwillig um redundante Internetanbindung, USV+Dieselgeneratoren und Klimaanlagen im Keller kümmern, wenn es nicht sein muss. Lösungen gibt es aber auch für KMU und den Mittelstand und Automatisierung von Routine-Aufgaben sollte jeder halbwegs faule Admin ja eh aus dem FF beherrschen.
Aber diese „Alles oder Nichts“-Mentalität nervt. Wer seine komplette Existenz ohne Plan B, ohne lokale Fallbacks und ohne echte Exit-Strategie in die Hände eines einzigen US-Tech-Giganten legt, darf sich nicht wundern, wenn aus einem „kleinen Konfigurationsfehler“ ein unternehmensweiter Totalausfall wird.
Hier ist es dann übrigens auch völlig egal ob bei SaaS, PaaS, IaaS-Lösungen oder in einer Cloud oder bei CoLocation. Irgendwas onPrem, auch wenns nur ne verstaubte Notlösung ist ist besser als gar nichts. Weiterarbeiten kann schon bei einer Login-Möglichkeit außerhalb der EntraID/AD scheitern oder bei einem unabhängigen Informationskanal für Notfälle. Das sollte man auf dem Schirm haben genau wie einen Plan B in der Schublade. Auch SAP (nein, nicht die Jungs aus Ba-Wü, ich meine hier tatsächlich Schreiben auf Papier) kann euch vorrübergehend helfen, wenn sonst gar nichts mehr geht. – Grüße gehen an der Stelle raus an die Dame aus der Weiterbildung von der ich das geklaut habe! Evtl. macht es auch mal Sinn bei der nächsten Sitzung mit dem ITSCM oder BCM-Beauftragten teilzunehmen 😉
TL:DR
Die Cloud ist eben doch kein magisches Nirvana, in dem Technik oder Software-Konfigurationen nie kaputtgehen. Sie ist am Ende des Tages auch nur der Computer von jemand anderem. Und wenn der brennt, brennt er für alle gleichzeitig.
Womit wir wieder beim heißen Herbst sind. 🔥Ich habe fertig!
Dreiste Eigenwerbung: Serie „Heißer Herbst“: Teil 1 | Teil 2 | Teil 3